WINBOY 系统标志:人机分面侧脸与耳机同心圆
WINBOY.AI
AI MUSIC & FUTURE
27TOOLS
48ENDPOINTS
<10msLATENCY
AI MUSIC COGNITION RUNTIME

不止生成
理解 · 解释 · 共演

当多数 AI 音乐工具停在"生成"层,WINBOY.AI 把内核建立在音乐认知运行时之上—— 从硅基芯片到云端 SaaS 的六层连续技术栈。感知、决策、表演、倾听、学习, 构成一个可验证、可审计的完整闭环。

实时频谱分析 REAL-TIME SPECTRUM
LIVE
<10msEND-TO-END LATENCY
128+GM INSTRUMENTS
110GOPSEDGE NPU
4,892TRACKS
0+PRODUCTS
0TOOLS · 12+15
0HTTP ENDPOINTS
0PHRASE LIBRARY
0TRACKS · AUDIO+MIDI
0脑ASSET·RUNTIME·PERF
IDENTITY · WINBOY / AI MUSIC & FUTURE

系统识别:造型锁定

背景与主色可自由适配不同场景,标志造型与字标始终如一。

深空青#05070D
VARIABLE / 可变
背景与主色

只调整配色与背景,标志造型始终如一;顶栏标志同步换色。

配色预设
主色相 0°
背景色 #05070D
明暗极性
LOCKED / 不可变
  • 标志造型:人机分面、耳机同心圆与神经网络
  • 字标:WINBOY 与 AI Music & Future
  • 所有配色下,品牌识别始终一致
下载当前配色 PNG 高清透明底 PNG
ARCHITECTURE · L0 → L5

六层全栈架构:从硅基到云端

不是单点工具,而是一条连续攀登的技术栈。每一层都可独立交付,同时共享同一套音乐认知内核。

L5 · API 层Developer Ecosystem

标准化工具集与流式能力,AI 助手即取即用。

  • 第三方集成与插件生态
  • 流式推理 · 商业包按量计费
L4 · 云端层SaaS / Studio / Private

VoiceAI Studio、VoiceLeader Creator、Rockit IDE、Model Platform,支持私有化部署。

  • 浏览器内离线运行
  • 永久授权 · 私有化定制
L3 · 智能终端层Robotics / Devices

Music Robit-Joy、VESPER、VoiceAI One、AI 麦克风、Mori 智能吉他、音乐机器人玩具。

  • 四级产品阶梯覆盖消费到专业
  • 听—奏—动—感沉浸互动
L2 · 边缘层On-device Runtime

离线可用、响应迅速,适配多种硬件形态。

  • 安装包 ~60MB 含全部模型
  • mW 级功耗 · 毫秒级响应
L1 · 芯片层iM3 / M200e / M220H

节拍、音高、情绪与协同演奏全面感知,端侧即可运行。

  • 五芯一链全方案交付
  • 参考设计与量产授权
L0 · 内核Music Brain · A/B/C

Evidence 证据层 → Belief 信念层 → Expression 表达层;Ear-Organ 听觉闭环。Memory + Personality = Identity

  • 信念可追溯 · 取代链 · 冲突可见
  • 听被视为与脑对等的器官
PRODUCT LINES · 14+ PRODUCTS

四条产品线,一个内核

从创作者工具到嵌入式芯片,每条产品线共享同一套音乐认知内核——所以能力可以跨形态复用,交付可以跨层级组合。

EXIS AI MusicCREATOR SUITE · AI BAND + AI SIGHT

一按风格就有一支听得懂你的乐队。AI Band 实时编曲,AI Sight 钢琴识别与练琴伙伴,便携工作室与 DAW 插件双形态交付。

  • 10 种可点风格人格,鼓贝斯铺底独奏会自然接话
  • 五线谱跟弹点亮、偏差与漏弹标注、可读练习建议
  • 风格库与工程统一管理,一键导出分轨与母带
¥129/月起SaaS · 私有化
VoiceAISTUDIO · CREATOR · LIVE · ONE

实时哼鸣音高控制、角色化声音、和声合唱、现场演出系统。浏览器内完全离线运行,安装包约 60MB。

  • 128+ GM 标准乐器,含演奏技巧
  • 少样本 voice cloning · 角色实例热切换
  • VoiceLeader LIVE 现场协作与舞台表现
¥199/月起SaaS · API · 私有化
Rockit IDEAGENT-NATIVE MUSIC IDE

面向 AI Music 的垂直创作环境,标准化能力开箱即用,AI 助手随取随调!

  • 12 Coding + 15 Music 工具,四大类别
  • Agent 运行时与分层权限管理
  • 四层记忆体:Working / Project / Evidence / Decision
¥169/月起开发者 · 平台授权
Robit & EdgeROBOTICS · EMBEDDED · HARDWARE

Music Robit-Joy 具身音乐协作角色、VESPER 高保真 3D 虚拟音乐人、M200e 端侧推理与五芯片硬件方案。

  • 12 位虚拟音乐家 · 曲库 4,892 首(音频+MIDI)
  • 统一驱动骨架 / 表情 / 演奏姿态资产
  • Mori AI 智能吉他、AI 麦克风、Pocket Master
5芯片定制开发 + 量产授权
SELLABLE MODULES · 11 REUSABLE

11 个可复用模块,按需组合

对外呈现产品能力,底层模型与算法参数仅在内部方案中说明。每个模块都可单独授权,也可打包成场景方案。

模块能力说明 适用场景
声音理解VOICE UNDERSTANDING 音高、节奏、调性、情绪识别——理解是所有下游能力的地基。
K歌教育玩具专业机器人
哼鸣音高控制PITCH-DRIVEN TIMBRE 哼鸣音高实时映射 128+ 标准乐器音色,端到端延迟 < 10ms。
K歌玩具教育专业机器人
人声效果VOICE EFFECTS 合唱、混响、变声、和声处理——把一把嗓子变成一支声部。
K歌玩具教育专业机器人
智能伴奏SMART ACCOMPANIMENT 自动编配、风格驱动,听得懂你的和弦与情绪再回应。
K歌玩具教育专业机器人
节奏与口技RHYTHM & BEATBOX 节拍检测与 B-box 合成,让机器跟得上也说得出。
K歌玩具教育专业机器人
和声与合唱HARMONY & CHOIR 2~4 部 SATB 真人和声,角色化声音可少样本克隆。
K歌玩具教育专业机器人
角色化声音VOICE PERSONAS 少样本 voice cloning,角色实例序列化、持久化、热切换。
K歌玩具教育专业机器人
音乐生成MUSIC CREATION 多风格作曲、乐句生成,5,000+ 高质量乐句库驱动。
K歌玩具教育专业机器人
节奏训练RHYTHM LEARNING 节拍跟踪、评分反馈,把练习变成可量化的成长曲线。
K歌玩具教育专业机器人
音频导出AUDIO EXPORT 多格式导出,练习与成品一次带走。
K歌玩具教育专业机器人
后期处理FINISHING & MASTERING 智能母带与混音,作品交付前最后一道工序内置。
K歌玩具教育专业机器人
SCENARIOS · 5 MARKETS

五大场景,各自的价值与周期

每个场景都有明确的目标用户、定制重点、交付周期与商业路径——不是"能做什么",而是"多久能交付、怎么收钱"。

K 歌声卡KARAOKE

目标用户:K 歌 / 直播 / KTV。核心价值:实时演唱体验。推荐形态:智能音频硬件。

  • 能力:人声效果 + 伴奏
  • 定制重点:音色、预设、交互
  • 交付周期:8–12 周
开发 + 量产授权
音乐玩具MUSIC TOY

目标用户:儿童 / 家庭 / 潮玩。核心价值:低成本声音互动。推荐形态:MCU / ARM 硬件。

  • 能力:声音识别 + 互动
  • 定制重点:成本、功耗、玩法
  • 交付周期:10–16 周
开发 + 量产授权
音乐教育MUSIC LEARNING

目标用户:学生 / 教师 / 机构。核心价值:练习反馈与成长。推荐形态:Web / App / 学习机。

  • 能力:检测 + 评分 + 伴奏
  • 定制重点:课程、评分、内容
  • 交付周期:8–12 周
项目开发 / SaaS
专业工具PRO TOOLS

目标用户:音乐人 / 制作人。核心价值:提升创作效率。推荐形态:插件 / 桌面端 / 云。

  • 能力:创作 + 编曲 + 导出
  • 定制重点:工作流、兼容、授权
  • 交付周期:12–16 周
SDK 授权 / 项目开发
音乐机器人MUSIC ROBOT

目标用户:玩具 / 娱乐空间。核心价值:沉浸式情感互动。推荐形态:机器人硬件。

  • 能力:音乐 + 动作 + 情绪
  • 定制重点:动作、情绪、结构
  • 交付周期:16–20 周
开发 + 量产授权
五阶段交付流程DELIVERY

每个阶段都有明确的客户决策点与可交付成果——不是一次性交付,是可验收的推进。

  • P0 1–3 天 需求初筛
  • P1 3–7 天 方案设计
  • P2 2–4 周 原型验证
  • P3 4–20 周 产品开发
  • P4 3+ 月 量产支持
按里程碑推进
ANIMATION DEMO ENGINE · 8 LIVE PANELS

动画演示引擎,每项能力都能当场验证

每个演示都可现场播放、实时交互,所见即所得。

05.1
人声实时变乐器 VOICE → INSTRUMENT · REAL TIME
真人演唱与钢琴声部同时发声 · 与乐队伴奏浑然一体
VOICE WAVE · PITCH TRACK · INSTRUMENT OUT 待机

VoiceAI — 唱一句,旋律即刻化为钢琴声部,与乐队伴奏同时响起。人声、钢琴、乐队三层自然咬合,情绪连贯、呼吸一致;演唱的表现力会带着钢琴一起起伏。原始演唱可独立开关,也可一键关闭钢琴声部,只留人声与乐队。
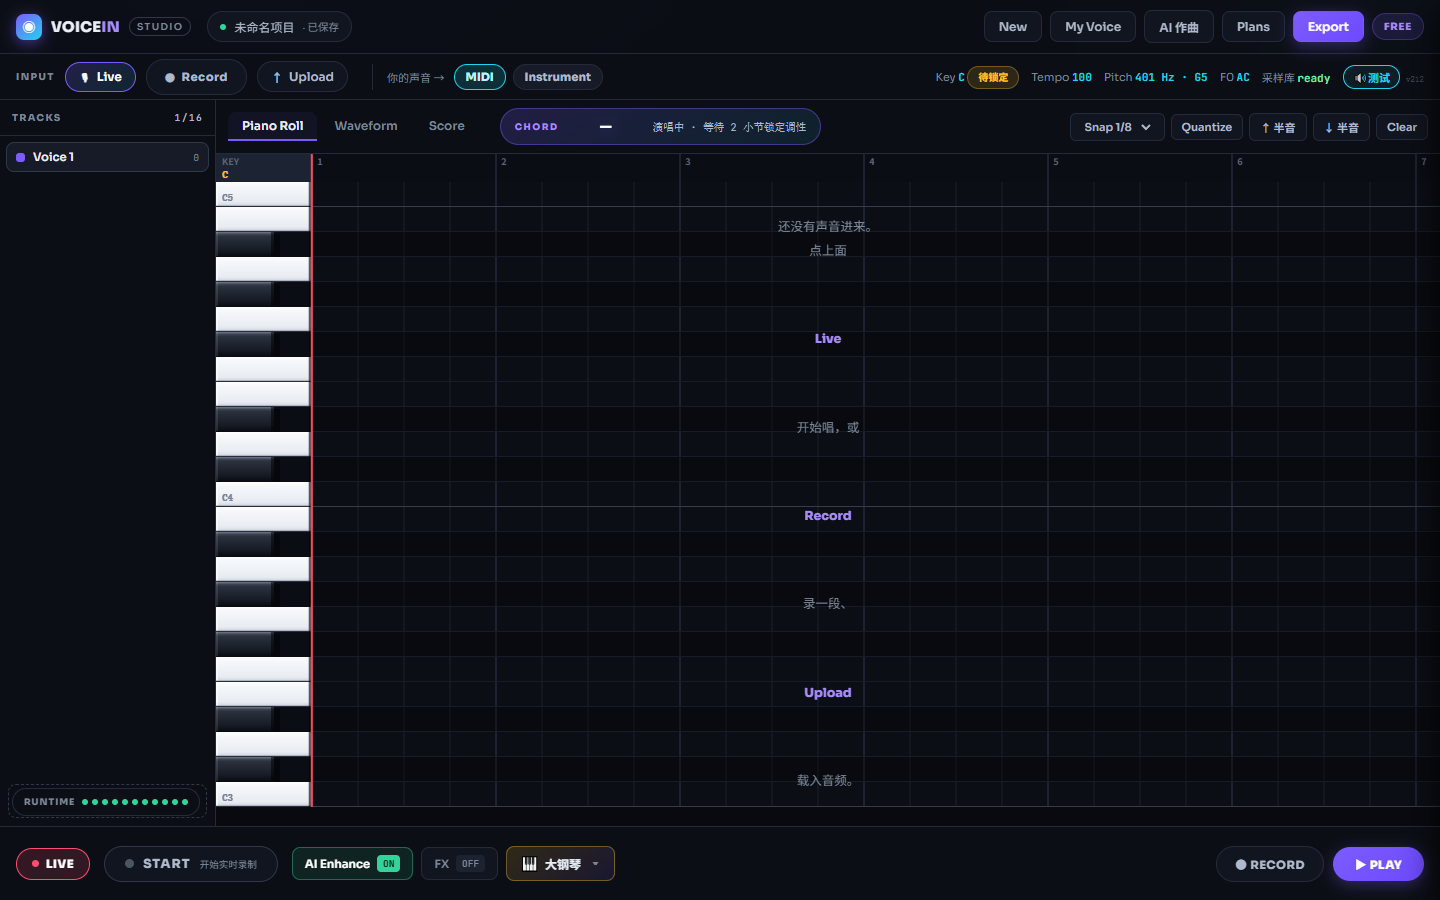
钢琴轨钢琴声部
链路三层同步 · 自然咬合
实时读数待机
表现力待机
钢琴轨
钢琴声部与乐队自然融合,可随时关闭,只留人声与乐队。
原始人声
原始演唱作为独立层,默认开启;演唱的力度变化会带动钢琴声部一起起伏。关闭后只听钢琴与乐队。
监听
「混合」=人声、钢琴、乐队三层同时发声;两端可单独试听,A/B 对照可在同一时间轴上切换。
6 路调制源
响度能量
明亮度
气息感
基频
颤音速率
空间感
六路表现力参数随演奏实时变化,驱动音色与动态层次。
乐队伴奏完整乐队编制贯穿全曲,与演唱、钢琴声部始终同步。
05.2
AI Band 实时编曲 REAL-TIME ARRANGEMENT
风格即人格 · 一键切换整支乐队的演奏气质
MULTI-TRACK ARRANGEMENT · LIVE 待机

AI Band — 鼓组、贝斯、键盘、铺底、弦乐、打击六个声部实时编配,切换风格即换一整支乐队。

当前风格2Step
风格人格
编制2Step / EasyListening / 电影弦乐 三种风格,一键整组切换。
说明切换风格时,律动、音色与织体同时变化,呈现截然不同的乐队气质。
05.3
A/B/C 认知架构 COGNITION ARCHITECTURE
Evidence → Belief → Expression · 可追溯的音乐认知生命周期
KNOWLEDGE FLOW · EVIDENCE → BELIEF → EXPRESSION 待机

A/B/C 认知架构 — A 层积累规律、B 层判断分寸、C 层完成表达,构成从理解到创作的完整路径。

架构层级A Evidence 证据层 → B Belief 信念层 → C Expression 表达层
关键机制每条规律都清楚何时适用;记忆更新有迹可循,不会静默覆盖。
工程落地创作工具 · Agent 运行时 · 分层权限
05.4
Robit 角色引擎 PERSONA-ROLE ENGINE
七项核心能力 · 随时切换 · 即刻生效
ROLE INSTANCE · 7 CORE CAPABILITIES 待机

Robit 角色引擎 — 角色是一组完整的能力组合,切换即刻生效,无需重启。

当前角色Joy
角色实例
角色能力
05.5
端侧推理预算 ON-DEVICE INFERENCE
端侧运行 · 完全离线
MODEL BUDGET · QUANTIZED · COMPILED · VERIFIED 待机

端侧推理 — 全栈自主可控,离线即可流畅运行。

技术主权不依赖外部服务,从能力到交付全链路自主可控。
部署约束完全离线可用 · 轻量安装 · 丰富音色
存储体系分层存储 · 实时响应
05.6
具身表情合成 EXPRESSION BASIS
六个维度 · 一次融合 · 自然表情
EXPRESSION COMPOSITION 待机

具身表情 — 六个维度实时融合,驱动口型、眉眼与微表情

事件信封统一事件结构,跨会话可追溯、可复现
管线状态多模态表情与 3D 表演已全面就绪
05.7
场景向量融合 3D SCENE FUSION
Vesper 项目 · 从音乐意图到舞台表现
SCENE VECTOR → PERFORMANCE · ENGINE-AGNOSTIC 待机

场景向量融合 — 光向、色温、曝光、反射、材质、空间密度六个维度实时融合,让角色外观、表演强度与声音氛围随环境一起改变。

六维场景向量光向 · 色温 · 曝光 · 反射 · 材质 · 空间密度
效果角色光照与配色随环境自动适应;表演强度与色板随场景切换;输出保持渲染一致性。
适配Unity / Unreal / 自研引擎通用——场景状态进,表演参数出。
05.8
Ear-Organ 听觉闭环 HEARING CLOSED LOOP
感知 → 决策 → 表演 → 倾听 → 评价 → 学习 · 全程可观测
CLOSED LOOP · OBSERVABLE METRICS 待机

听觉闭环 — 让 AI 音乐人真正会听、会配合、会成长。

Rockit 五套验证长时稳定运行 · 表现一致性 · 反馈修正 · 持续学习 · 批量生成质量
质量观测每项能力都有清晰的质量指标,进展可量化、可对照。
工程纪律把"反应式音乐"从演示变成可写进方案的工程标准。
GUITARVERSE · 吉他星途

GuitarVerse,录音级音色建模

不止于"生成音乐",而是把乐器表现力变成可演奏、可教学、可组团的完整体验。

0TAB 曲谱库
0音色素材
0乐器音色组
0和弦语汇
0独奏乐句
0伴奏曲库
系统化资产体系ASSET SYSTEM

音色、曲谱与课程内容统一管理,随取随用:

  • 音色与技法库 — 覆盖多种吉他音色与演奏技法
  • 曲谱与课程 — 和弦、调性、难度与示范曲目一体呈现
  • 统一资产体系 — 内容与演示、教学、练习无缝联动
五阶段学习旅程GUITAR AI JOURNEY

从选琴到独立演奏的完整进阶路径,AI 反馈贯穿全程。

  • 仪表盘 · AI 老师 · Jam Station · 工具箱
  • 曲谱库 · 和弦库 · 技巧库 · Solo 库 · 指板库
  • 练习模式 · 进度追踪
九个演奏技巧TECHNIQUES

从真实曲谱解析出的技巧标注,每个技巧都带难度分级、练习建议与示例曲目。

  • 延音 · 闷音 · 击弦 · 揉弦 · 推弦 等 9 类
  • 入门 / 中级 / 高级 三级难度标注
  • 每条技巧附练习动作与推荐曲目
05.9
展示画面 × 配乐素材 TAB VIEW × BACKING AUDIO
TAB 曲谱 · 实时和弦 · 与音乐同步的播放头与波形
TAB VIEW LIVE CHORDS
真实 TAB 曲谱
载入曲谱归档…
CURRENT CHORD
—
真实 TAB 曲谱
⤢
载入真实曲谱…
PROGRESSION
BAR 1 · 1 / 4
待机

展示画面 × 配乐素材 — TAB 曲谱以纸感卡片呈现(点击换谱、右上角放大看全谱),实时和弦随曲谱与配乐每小节推进,播放头与波形跟随音乐律动;六种风格配乐随心切换。

展示画面12 张 TAB 曲谱(布鲁斯、扫弦、指法、把位移动等)。点击纸卡切换下一张,右上角按钮放大查看完整谱面,播放时随音乐轮播。
配乐片段
说明和弦随当前曲谱调性(D / A / C / G / 布鲁斯 I-IV-V)按小节推进,画面与音乐始终同步。
COGNITION & NARRATIVE · THREE PROJECTS

从乐谱到叙事,三条纵深栈

sightAI 把符号音乐变成可训练的数据底座;NOX 把结构失效变成可反证的因果场理论;Kaelo Film 把影视生产变成人生叙事重构。三者共享同一套工程纪律:先定规范,再谈实现。

sightAISYMBOLIC MUSIC DATA PLATFORM

让曲谱、指法与练习数据变成可复用的音乐知识。

  • 多种曲谱格式统一接入
  • 统一的结构化表达与质量管理
  • 可扩展的知识组织方式
  • 乐句续写、指法纠错与演奏映射
持续扩展中
NOXCAUSAL FIELD THEORY

让系统的每一次判断都有因果依据,可解释、可推演。

  • 因果建模:从现象到成因
  • 结构演化:识别变化从哪里开始
  • 守恒视角:让"为什么变"可被观察
  • 可计算的推演:从判断到行动
持续演进
Kaelo FilmHUMAN NARRATIVE RECONSTRUCTION

人生叙事重构系统。不生产视频,生产叙事——视频只是叙事的输出形式。

  • 从真实片段到完整叙事
  • 主题、人物、世界、故事一气呵成
  • 统一的创作原则与对象体系
  • 叙事质量持续打磨
体系化推进中
05.10
sightAI 数据管线 MUSICIR PIPELINE
TAB / GT 乐谱 → 归一化事件 → 统一中间表示 → Token 序列
TAB / GT 乐谱 → 统一中间表示 → TOKEN SEQUENCE 待机

sightAI — 暂缓音频转录与 OMR,先把 TAB 与 GT 乐谱变成稳定的数据底座,这是可训练的前提。

统一中间表示内容小节、拍点、音符、和弦、指法、技巧标记,以及乐谱与指板的映射
数据集产物预训练样本 · 指令样本 · 检索嵌入 · 评估夹具
工程纪律先跑通"决策→证据→溯源"闭环,再允许上复杂架构
05.11
NOX 因果场栈 CAUSAL FIELD STACK
Claim → Dynamics → Invariant → Observatory → Atlas → Geometry → Topology → Field → Action → Quantization
CAUSAL FIELD · 10-LAYER CLOSURE 待机

NOX — 三轴 + 本体论四闭环:动力轴(How)、生成轴(Why)、选择轴(Which)、计算轴(Discrete)。

层级锁死Geometry 回答"如何改写空间",Topology 回答"什么不变",SFCT 回答"为什么变",SAP-V 回答"哪条路径成为现实",SFQ 回答"如何离散可算"
关键升级Geometry v0.2 → v0.3:失效不再是流形上的点事件,而是结构空间上的形变算子
可反证性NOX Claims 规范要求每条主张都可被反证,并配套 Layer A 遥测数据源
05.12
Kaelo Film 叙事管线 NARRATIVE PIPELINE
现实捕获 → 意义引擎 → 意义图谱 → 叙事引擎 → 叙事蓝图 → 世界模拟 → … → 影视包
HUMAN NARRATIVE RECONSTRUCTION 待机

Kaelo Film — 不是把素材拼成视频,而是从真实片段中重构出动人故事。

核心立场以人为中心的叙事重构
创作原则主题、人物、世界、故事始终先行,一切能力围绕叙事展开
统一设定人物、场景与事件在统一设定下保持一致
COMMERCIAL · B2B2C

四种合作模式,清晰的价格阶梯

报价不只取决于功能数量,更取决于平台、周期、定制深度与授权范围。内核源码授权价格带 ¥360K – ¥1,500K / 永久项目。

定制开发 + 量产授权CUSTOM + ROYALTY

开发费 + 单台授权费,适合硬件、玩具与机器人客户。

硬件 / 玩具 / 机器人
项目制开发MILESTONE PROJECT

按阶段验收付款,适合教育平台与专业软件厂商。

教育 / 专业软件
SaaS 订阅SUBSCRIPTION

按月 / 按用户计费,适合教育平台与云端服务客户。

教育平台 / 云服务
SDK / 平台授权PLATFORM LICENSE

年度或平台级授权,适合插件厂商与平台合作伙伴。

插件 / 软件厂商
报价构成PRICING ANATOMY
  • 方案与原型(discovery & prototype)
  • 产品开发(product build)
  • 平台适配(platform integration)
  • 内容与交互定制(content / UX)
  • 量产支持(scale-up)
  • 授权范围(license scope)
市场与差异化MARKET & DIFFERENTIATION
  • 全球 AI 音乐约 $4.5B(2025),CAGR ≈ 24%
  • Suno / Udio:文本生成歌曲 → 我们做实时转换、现场演出、离线端侧
  • AIVA:媒体作曲 → 我们做哼鸣音高控制 + 乐器音色映射
  • Moises:分轨练习 → 我们做钢琴识别 + 全乐队生成
  • Landr:母带分发 → 我们做创作侧实时编配与音色映射
KEY METRICS · AT A GLANCE

关键指标,一眼看清规模

一页式核心数据,用于客户演示与投资人沟通。

0+PRODUCTS
0TOOLS
0能力接口
0ms曲库规模
0VIRTUAL MUSICIANS
0CHIP SOLUTIONS
0GOPS端侧算力
0+INSTRUMENTS
0+PHRASE LIBRARY
0客户触达
0%客户回应
0重点商机

把"反应式音乐"从演示
变成可写进方案的工程标准

无论你要做可玩广告的游戏音频、陪练产品、音乐玩具还是机器人—— 我们提供从芯片、端侧 Runtime、云端 SaaS 到具身角色的整条交付链, 全链路自主交付。

再看一遍演示 下载能力清单 jack_liu@voice-ai.live · voice-ai.live · linkedin.com/in/pk-liu-28b330283
Jack Liu
Audio & AI Systems Architect